PoppyDB geht live — Messungen vom echten Bus
So weit waren wir noch nie! PoppyDB ist produktiv gegangen. Auf unserem echten Message-Bus. Drei Knoten. MongoDB an derselben Stelle ersetzt. Die fiesesten Bugs hatten wir schon im Testbetrieb gefunden und beseitigt. Jetzt ging es darum rauszufinden, ob PoppyDB im Protuktivbetrieb hält, was die Tests versprochen haben.
Der Weg dorthin: 16 Releases in zweieinhalb Monaten
Eigentlich ist der Go-Live-Tag nicht die ganze Geschichte. Die Geschichte ist, wie wir hinkamen. Morphium 6.3.0 kam am 9. August raus. Am 21. Oktober lief 6.3.15 auf dem Bus. Dazwischen liegen sechzehn Releases.
Nicht, weil nichts funktioniert hätte - klar, es gab auch Bugs, insbesondere in Lastsituationen oder Failoverfällen. Sondern weil wir jede Messung aus der Abnahme sofort zurückgebaut haben, um gleich testen zu können. Siehe changelogs: Da steht 6.3.2 und 6.3.3 am selben Tag. Dann 6.3.4, 6.3.5 und 6.3.6 auch am selben Tag. Das war die Phase, in der wir die Befunde abarbeiteten. Danach wurde es ruhiger, weil die Funde seltener wurden.
Über das Tempo kann man denken, was man will. Es hat hier gut funktioniert. Jedes Release war klein. Drin war nur, was aus einer konkreten Beobachtung kam. Kein Sammelrelease mit zwanzig Sachen, von denen die Hälfte später wieder auffällt. Das schafft man nur mit guter Testabdeckung. Zum glück haben wir in Morphium (und auch PoppyDB) viel Wert darauf gelegt. Die Suite mit über 2.200 Tests musste grün bleiben!
Diese ganzen Tests, das Lastprofil, die Messungen haben uns gezeigt: PoppyDB kann auf Produktion eine Menge sparen und last reduzieren. Das geht natürlich nur in diesem besonderen Anwendungsfall. Naturgemäß ist eine InMem-Datebank vom verfügbaren RAM her beschränkt. Aber unser Anwendungsfall (Message-Bus) erzeugt nur wenige Daten - die aber schnell weiter gegeben werden müssen.
Der Swap
Am Vormittag des 21. Oktober haben wir das MongoDB-Replica-Set rausgenommen. PoppyDB kam an dieselbe Stelle. Gleicher Port. Gleiche Hosts. Gleiche Knotenzahl. Die Clients haben nichts gemerkt.
Jetzt ging es drum rauszufinden, ob PoppyDB wirklich gut auf Produktion funktioniert. Dafür haben wir gemessen. Durchsatz, Latenz, Fehler, Log, Ressourcen. Als Vergleich dient der letzte volle Produktionstag mit MongoDB davor. Dieselben Uhrzeiten, damit der Vergleich fair bleibt.
Durchsatz - mehr ist immer gut
Der erste Befund bestätigt die Hoffnung aus dem Labor. PoppyDB hält auf Prod nicht nur mit - sie ist flotter und braucht weniger Ressourcen.
Im validen Fenster, wo beide Tage sauber vergleichbar sind, waren es rund 13,6 Prozent mehr Nachrichten pro Stunde als am Referenztag. Pro Stunde gerechnet lag PoppyDB zwischen fünf und 27 Prozent vorn - mit echten Daten von einem echten Protuktivsystem.
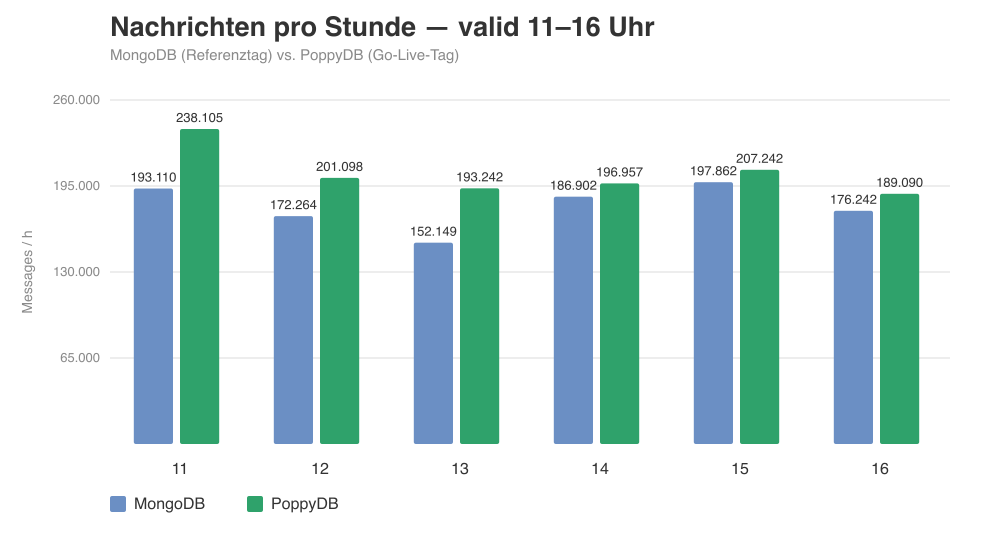
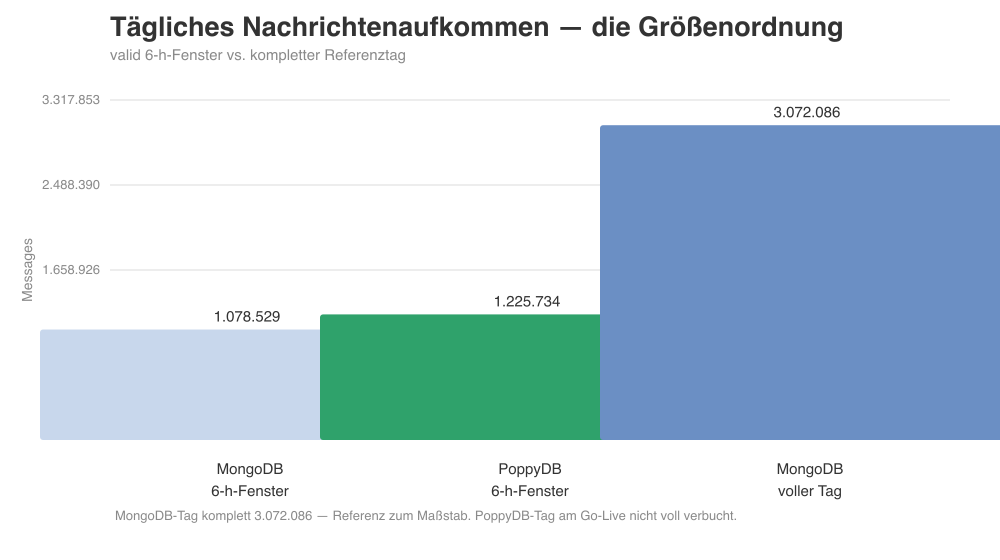
Damit das nicht so abstrakt bleibt, ein paar absolute Zahlen. Auf dem Bus laufen mehr als 500 Topics. An einem normalen Werktag sind das rund 3 Millionen Nachrichten. Im gemessenen Sechs-Stunden-Fenster waren es gut 1,08 Millionen auf MongoDB und 1,23 Millionen auf PoppyDB. Bei so viel Verkehr machen die 13,6 Prozent einen echten Unterschied.
Zur Einordnung: Der Mikro-Benchmark aus der Abnahme brachte ungefähr das 3,5-fache beim Bus-Roundtrip. Dass sich das nicht eins zu eins auf Prod überträgt, war zu erwarten. Hier misst du echtes Gesamtverhalten. Aber der Durchsatz steigt, während die Latenz sinkt. Genau das hatten wir uns von einer DB mit weniger Overhead erhofft.
Latenz - weniger ist mehr
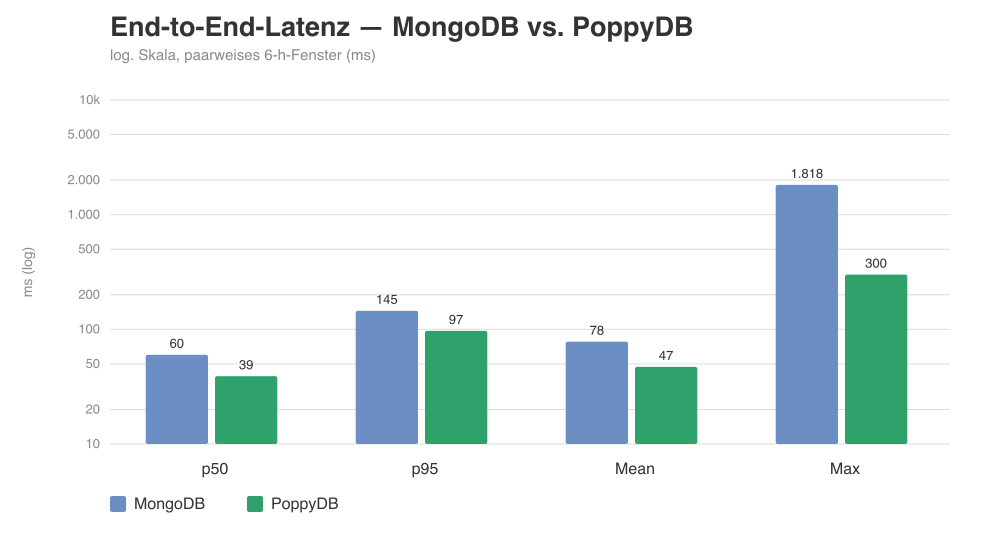
hier ein paar konkrete Zahlen. Die End-to-End-Latenz über den Bus, paarweise im selben Sechs-Stunden-Fenster:
| Metrik | MongoDB | PoppyDB | Δ |
|---|---|---|---|
| Median (p50) | 60 ms | 39 ms | −35 % |
| p95 | 145 ms | 97 ms | −33 % |
| Mittelwert | 78 ms | 47 ms | −40 % |
| Maximum | 1.818 ms | 300 ms | −83 % |
Drei Zahlen stechen dabei heraus. Die Spitzen sind um 83 Prozent eingebrochen. Das ist auf einem Message-Bus das Wertvollste. Genau die Ausreißer erzeugen Timeouts und Folgefehler. Der p95 liegt unter 100 Millisekunden. Vorher waren es 145. Und der Median steht bei 39 Millisekunden.
Über das volle 24-Stunden-Fenster gerechnet blieb es dabei: p50 bei 40 ms, p95 bei 96 ms, Maximum 300 ms. Das bleibt stabil über den ganzen Tag so. 👍
Stabilität: weniger Ausreißer
Den größten Unterschied siehst du nicht im Durchschnitt. Gerade die Probleme von zu hoher Last im alten System mit mongodb sollte PoppyDB angehen. Und das zeigen die Zahlen eindeutig.
Im selben Fenster hatte der MongoDB-Tag 50 Bus-Timeouts. PoppyDB im selben Fenster: null. Die Slow-Query-Logzeilen fielen von knapp 30.000 auf 17. Das ist rund 1.760-mal weniger. Und das gesamte Server-Log-Volumen schrumpfte um den Faktor 17.
Ob Logs als Belastung zählen, darüber kannst kann man wohl vortrefflich streiten. Ich zähle sie dazu. Ein Log, das 30.000-mal knurrt, ist nicht zwingend ein "Lautes Log". Aber sowas verursacht durchaus auch Last am System.
In den folgenden 25 Stunden: kein Ausfall, kein Neustart, durchgehender Heartbeat aller Knoten. PoppyDB-eigene Slow-Queries: 48 in 25 Stunden. mongod hatte rund 30.000 allein in sechs. Und abgewiesen wurde nie, auch nicht am 90-Prozent-Heapschwellwert.
Ressourcen: entspannt
Die Knoten lagen im Tagesmittel bei einstelligen bis niedrigen zweistelligen CPU-Werten. Mit gelegentlichen Spitzen. Der Heap blieb über 24 Stunden konstant bei gut 5 GB im Mittel. Kein Leck.
Was wir dabei gesehen haben, könnte man ggf. noch verbessern. Der G1-GC oszilliert stündlich bis nah an die 12-GB-Grenze. Die Heap-Warnschwelle klingelt regelmäßig. Abgewiesen wurde nie. Aber genau das haben wir uns für den nächsten Schritt vorgemerkt: das Puffer- und Heap-Budget gezielt anschauen. Statt es zufällig kollidieren zu lassen.
Die Vorbehalte
Wie bei den anderen Posts, hier die Grenzen der Zahlen. Der MongoDB-Referenztag ist ein Dienstag, der PoppyDB-Tag ein Mittwoch. Keine identischen Wochentage, aber dicht beieinander im Betriebsprofil. Die Zahlen vom Vormittag des Go-Live-Tags waren nicht vollständig verbucht. Deshalb stützen sich die Durchsatzvergleiche nur auf die Stunden ab 11 Uhr. Slow Query ist bei mongod und PoppyDB nicht exakt dasselbe Format. Die Kennlinie ist dieselbe. Und vor dem Swap gab es keinen Direkt-Benchmark auf Prod. Die Mikro-Zahlen stammen aus der Abnahme.
Keiner dieser Vorbehalte dreht die Richtung um. Aber nehmt die Prozente nicht auf die dritte Stelle genau.
Was bleibt
PoppyDB ist auf Prod angekommen (yeah!). Durchsatz mindestens wie erwartet eher höher. Latenzen ein Drittel bis 40 Prozent tiefer. Spitzen 83 Prozent tiefer. Die "Bremsspuren", also Timeouts, Slow Queries und Log-Knurren, sind praktisch weg. Stabil über 24 Stunden. Kein Leck. Kein Neustart.
Und der Weg dorthin gehörte dazu. Die 16 Releases in zweieinhalb Monaten. Jede Zahl, die ich heute vorlegen kann, kommt aus einer Beobachtung, die wir damals zurückgebaut haben.
PoppyDB und Morphium 6.3.15 gibt es auf Maven Central. Die Changelogs der ganzen 6.3.x-Reihe auf GitHub.